
O Google anunciou o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking, dois modelos de voz em tempo real disponíveis pela Live API e pelo Google AI Studio. A diferença mais importante não é simplesmente “falar com uma IA”: a versão comum prioriza respostas rápidas, enquanto a Extended Thinking tenta planejar tarefas mais complexas sem deixar o usuário ouvindo um silêncio constrangedor.
Na prática, a novidade interessa principalmente a quem cria atendimento por voz, tutores, suporte técnico, busca falada e automações que precisam consultar ferramentas. Para o usuário comum, o lançamento aparece no Gemini Live, no Search Live e em alguns recursos do Google Workspace; para desenvolvedores, ele traz uma arquitetura mais direta para montar agentes que escutam, respondem e executam ações.
O que muda no Gemini 3.8 Live
O Gemini 3.8 Live foi desenhado para conversas de baixa latência. Em vez de transformar toda fala em texto, enviá-la a um modelo textual e depois gerar áudio em outra etapa, a proposta é usar fala para fala de forma nativa. Isso pode reduzir a sensação de “robô montando a resposta” e facilitar interrupções e turnos mais naturais.
O modelo também recebe entradas visuais em tempo quase real, segundo o anúncio do Google, e consegue alternar automaticamente entre 97 idiomas durante a conversa. Ele pode chamar ferramentas e APIs enquanto mantém o diálogo, algo útil para um agente que consulta estoque, lê um sensor ou busca o status de um pedido.
Extended Thinking tenta esconder a espera das ferramentas
A versão Gemini 3.8 Live Extended Thinking foi feita para pedidos que exigem mais planejamento. Enquanto uma função externa é executada, o modelo pode emitir atualizações curtas, como “vou verificar as opções”, e continuar a interação. A ideia é mascarar a latência da ferramenta sem fingir que a resposta final já está pronta.
Essa diferença muda também o código do aplicativo. Em uma sessão comum, o desenvolvedor pode usar turnComplete: true para identificar o fim do turno. No modelo com raciocínio em segundo plano, a documentação orienta acompanhar interaction_status: IN_PROGRESS indica que a tarefa ainda está em andamento e IDLE sinaliza que o agente voltou a esperar o usuário.
Há outro detalhe fácil de perder: as funções usadas pelo Extended Thinking precisam ser declaradas como não bloqueantes, com behavior: NON_BLOCKING. Uma integração que espera uma função síncrona terminar pode falhar mesmo que o restante do código esteja correto.
Os números parecem bons, mas vêm do próprio anúncio
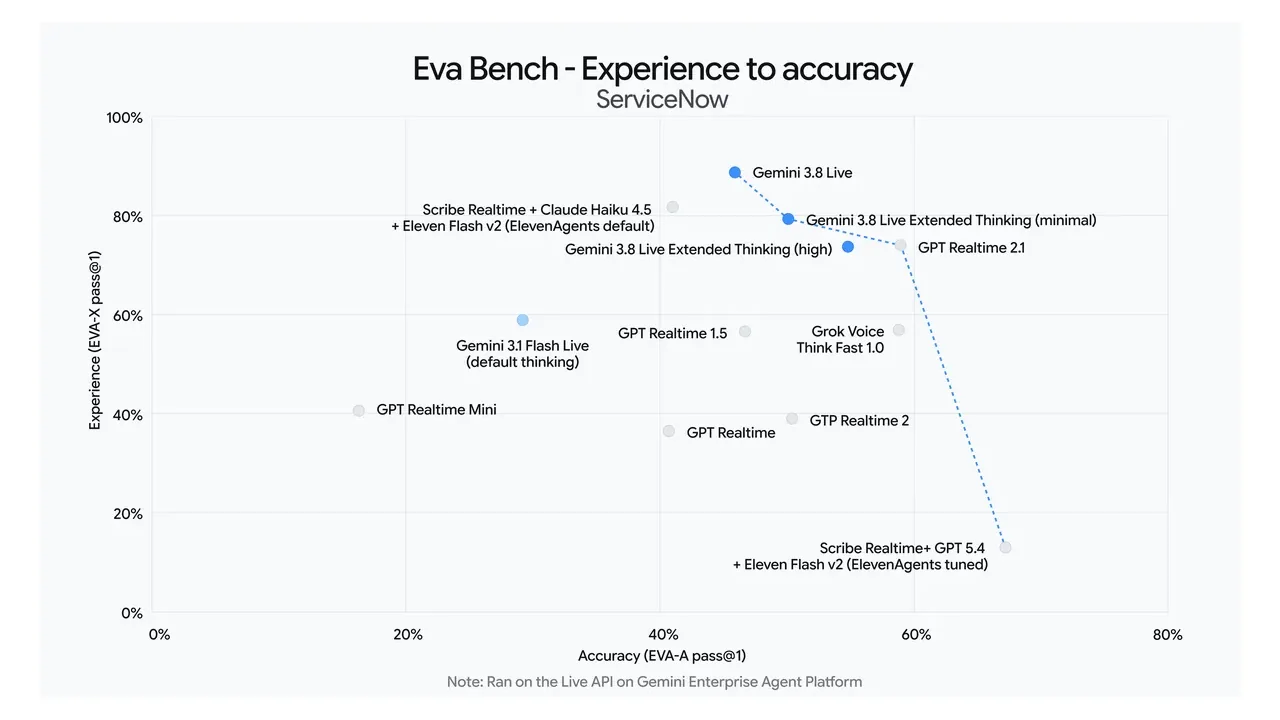
O Google afirma que o Gemini 3.8 Live Extended Thinking alcançou o primeiro lugar no Speech to Speech Quality Index da Artificial Analysis, com pontuação 82,6, além de resultados de 68,6% no τ-Voice e 35,1% no benchmark bancário da Sierra. Também cita 97,7% no Big Bench Audio.
Esses números ajudam a entender a ambição do lançamento, mas não são um teste independente feito pelo JSMS. No material sobre o EVA-Bench, o próprio Google informa que a execução ocorreu na Live API do Gemini Enterprise Agent Platform. O leitor deve tratar os resultados como evidência apresentada pela empresa, não como garantia de que qualquer aplicação terá a mesma qualidade.
Quanto custa e onde está disponível
No anúncio de 15 de setembro de 2026, o Google informa preço de US$ 0,005 por minuto de áudio de entrada e US$ 0,018 por minuto de áudio de saída. É um valor de referência da API, não uma estimativa final em reais: impostos, câmbio, texto, transcrições, ferramentas e o desenho da sessão também entram na conta.
Os dois modelos estão disponíveis pela Live API e no Google AI Studio. A documentação ainda identifica a Live API como uma prévia, portanto mudanças de preço, limite e comportamento são possíveis. No Gemini 3.8 Live, o Google diz que o áudio proativo fica permanentemente ativado; isso merece atenção porque a aplicação pode continuar consumindo entrada enquanto permanece escutando.
O limite que pode surpreender: sessões não são infinitas por padrão
A documentação do Live API informa que, sem compressão de contexto, sessões apenas com áudio ficam limitadas a 15 minutos e sessões com áudio e vídeo a 2 minutos. A conexão também dura cerca de 10 minutos. Para conversas mais longas, o desenvolvedor precisa configurar compressão de contexto e retomada de sessão.
Isso é particularmente importante em suporte e atendimento. Um agente que parece funcionar em uma demonstração de três minutos pode cair quando uma conversa real se alonga. Também é preciso controlar o histórico: a documentação alerta que o contexto acumulado pode aumentar a cobrança por turno, e transcrições adicionam tokens de texto à conta.
Para quem a novidade faz sentido
- Atendimento e triagem: o Live comum pode servir para perguntas diretas e consultas rápidas.
- Suporte técnico: o Extended Thinking faz mais sentido quando precisa comparar logs, configurações e respostas de ferramentas.
- Educação: um tutor de voz pode explicar código, fórmulas e exercícios em etapas, desde que o responsável revise as respostas.
- Casa inteligente: comandos curtos, como consultar sensores ou acionar dispositivos, combinam com baixa latência.
Para uma empresa pequena, porém, o lançamento não elimina o trabalho difícil. Ainda é necessário autenticar usuários, limitar permissões, registrar chamadas, tratar interrupções, proteger dados e criar uma saída segura quando a ferramenta estiver indisponível. Voz mais natural melhora a interface; não transforma um fluxo mal planejado em um bom produto.
Gemini 3.8 Live vale a pena?
Para quem já constrói aplicações de voz, o Gemini 3.8 Live é uma atualização relevante porque reúne fala, visão e chamadas de ferramentas em uma sessão bidirecional. A versão Extended Thinking é mais interessante para tarefas em várias etapas, mas exige mudanças no controle de estado e nas funções assíncronas.
Minha leitura é menos empolgada que o marketing: o Google resolveu uma parte visível do problema — o silêncio durante a espera —, mas transferiu complexidade para o projeto. Antes de colocar um agente desses no atendimento, vale medir latência, custo por sessão, taxa de interrupção, qualidade em português e o comportamento quando a API ou uma ferramenta falha.